BCI : simuler la calibration et le bruit
Explication
Nous avons exécuté notre propre expérience Monte-Carlo pour étudier combien de données personnelles améliorent un décodeur BCI. Son générateur est ajusté sur 540 essais EEG de 12 personnes, réellement traités dans notre analyse précédente. Les nouvelles campagnes sont simulées : elles prédisent le comportement d’un modèle de mesure humaine, sans constituer de nouvelles mesures chez l’humain.
Chaque personne virtuelle produit des observations de calibration, puis un test indépendant. Nous faisons varier le nombre d’essais personnels, le bruit et la stabilité du signal. Notre critère, choisi pour cette expérience, est un gain moyen d’au moins cinq points par rapport au même système sans essai personnel étiqueté. Ce n’est pas un seuil clinique.
Dans le scénario qui conserve les contrastes ajustés aux EEG, ce critère est atteint à 64 essais étiquetés avec correction par référence, contre 128 avec le bruit ajouté non corrigé. La correction demande aussi 256 observations personnelles non étiquetées. Le résultat porte donc sur la réduction des essais guidés ; le coût total de collecte doit inclure cette référence.
Le nombre nécessaire dépend fortement des hypothèses. Si nous divisons le contraste entre les tâches par deux, ou si nous triplons l’amplitude de la dérive entre blocs, le critère n’est plus atteint jusqu’à 256 essais. Une simulation donne ici une réponse conditionnelle et des situations à tester, pas un nombre universel valable pour chacun.
Analyse détaillée
1. Ce que nous simulons d’une mesure humaine
Notre point de départ est le jeu EEG Motor Movement/Imagery de PhysioNet, attribué à Gerwin Schalk et aux contributeurs BCI2000. Nous conservons six valeurs par essai : les puissances logarithmiques de C3, Cz et C4 dans deux bandes, de 8 à moins de 13 Hz et de 13 à moins de 30 Hz. Elles proviennent des segments humains de trois secondes déjà extraits.
Pour chaque personne, nous ajustons un niveau moyen, une différence entre les consignes gauche/droite, les fluctuations des six valeurs ensemble et un décalage entre blocs d’enregistrement. Le Monte-Carlo tire de nouvelles observations selon ces distributions. Il produit les valeurs que reçoit notre décodeur ; il ne reconstruit ni une anatomie ni une forme d’onde EEG complète.
Chaque campagne choisit l’un des douze profils ajustés. Les onze autres profils génèrent chacun 48 essais pour le modèle de départ. Le profil cible génère séparément la calibration et 1 200 essais de test. Le décodeur ne reçoit ni les paramètres cachés de la personne virtuelle ni les réponses du test. Les campagnes renouvelées ne créent pas une diversité biologique supplémentaire.
Les données d’origine contiennent 45 essais par personne. Les budgets plus élevés extrapolent les distributions ajustées. Les différences entre classes peuvent aussi contenir des effets de la consigne visuelle ou des artefacts : notre simulation ne prouve pas que toute l’information soit une intention motrice.
2. Une expérience répétée, avec ses hypothèses écrites
Nous avons exécuté 600 campagnes par hypothèse, avec les budgets 0, 4, 8, 16, 32, 64, 128 et 256 essais étiquetés. Les classes sont équilibrées. Un budget contient les premiers essais des budgets suivants ; le test est entièrement distinct. Les conditions partagent leurs tirages aléatoires pour permettre une comparaison appariée.
Le modèle de départ est une analyse discriminante linéaire. La calibration personnelle adapte ses moyennes et sa covariance : le poids des essais personnels est \(n/(n+16)\), pour \(n\) essais. Le reste provient du modèle source. La régularisation du décodeur est fixée à 0,1 vers la diagonale de covariance. Nous avons aussi calculé un comparateur utilisant les seuls essais personnels. Les paramètres sont fixés avant les courbes, sans préenregistrement externe.
Les quatre hypothèses conservent les contrastes empiriques, les divisent par deux, triplent la dérive, ou suppriment tout contraste entre classes. Les deux modifications sont des tests de sensibilité choisis, sans prétention à représenter une population clinique particulière. Le cas sans contraste sert de contrôle négatif.
3. Le bruit ajouté et les moyens de le réduire
Le niveau initial contient déjà la variabilité issue des EEG humains. Nous ajoutons deux perturbations corrélées entre canaux dans l’espace des caractéristiques. Elles représentent une nuisance commune, avec une intensité fixée. Ce modèle n’est pas une simulation électromagnétique : ses unités ne sont ni des volts ni des teslas, et il ne reproduit pas un parasite temporel à 50 Hz.
- Sans bruit ajouté. Conserver la variabilité du générateur ajusté aux données humaines.
- Bruit ajouté, sans correction. Perturber la mesure de la personne cible pendant calibration et test.
- Correction par référence. Mesurer aussi le parasite avec des capteurs virtuels imparfaits, apprendre sa contribution sur 256 observations non étiquetées indépendantes, puis la soustraire.
- Atténuation supposée. Réduire à 20 % l’amplitude du parasite ajouté. C’est une hypothèse du simulateur, sans performance matérielle démontrée.
- Référence contaminée. Laisser une partie de l’activité utile atteindre le capteur de référence, pour éprouver le risque de la retirer avec le bruit.
Les observations de référence sont un coût personnel supplémentaire. Le modèle source utilise également les observations synthétiques des autres profils. « Zéro essai étiqueté » signifie donc une absence de calibration guidée ; dans la condition corrigée, il reste des données personnelles de référence.
4. Combien d’essais améliorent le décodeur dans ce modèle ?
Le critère demande un gain moyen d’au moins cinq points, une borne inférieure Monte-Carlo positive et le maintien du critère à tous les budgets supérieurs testés. Nous retenons le premier budget de la grille qui le satisfait. L’exactitude est équilibrée puisque le test comporte autant d’essais de chaque classe.
| Condition simulée | Essais étiquetés | Observations de référence supplémentaires |
|---|---|---|
| Sans bruit ajouté | 64 | 0 |
| Bruit ajouté, sans correction | 128 | 0 |
| Correction par référence | 64 | 256 |
| Atténuation supposée | 64 | 0 |
| Référence contaminée | 64 | 256 |
Avec la référence, le score passe de 52,1 % à 58,1 % entre zéro et 64 étiquettes : 6,0 points de gain, avec un intervalle Monte-Carlo de 5,5 à 6,5 points. Au même budget de 64, le bruit non corrigé donne 55,6 %. Le score demeure modeste, même quand le critère exploratoire est atteint.
Le minimum de 128 dans le bruit non corrigé est plus fragile : son gain moyen est de 5,03 points, avec un intervalle de 4,6 à 5,5 points qui traverse la frontière des cinq points. La grille et la précision numérique ne permettent pas d’affirmer qu’un essai de moins ferait échouer la méthode.
Gain selon la calibration simulée
600 campagnes par condition, scénario empirique.
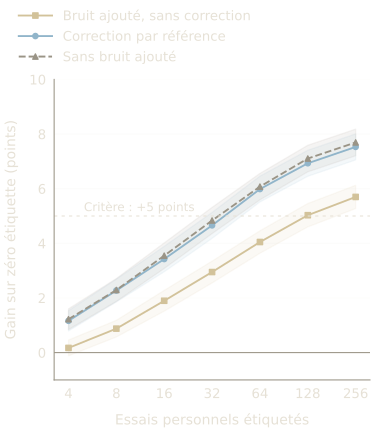
Lire les scores moyens à chaque budget
| Essais étiquetés | Sans bruit ajouté | Bruit non corrigé | Référence |
|---|---|---|---|
| 0 | 52,1 % | 51,6 % | 52,1 % |
| 4 | 53,3 % | 51,7 % | 53,3 % |
| 8 | 54,4 % | 52,4 % | 54,4 % |
| 16 | 55,7 % | 53,5 % | 55,5 % |
| 32 | 57,0 % | 54,5 % | 56,7 % |
| 64 | 58,2 % | 55,6 % | 58,1 % |
| 128 | 59,2 % | 56,6 % | 59,0 % |
| 256 | 59,8 % | 57,3 % | 59,6 % |
Le budget corrigé comporte 64 essais guidés et 256 observations de référence, soit 320 observations personnelles dans notre construction. Le budget non corrigé de 128 n’a pas ce coût de référence. Nous avons donc mis en évidence une réduction conditionnelle des étiquettes nécessaires, tout en rendant visible le supplément de mesure. Aucune durée de séance humaine n’est déduite de ces nombres.
5. Quand davantage de données ne suffit pas
Après correction par référence, le gain à 256 essais tombe à 3,3 points quand le contraste est divisé par deux, et à 4,6 points quand l’amplitude de la dérive triple. Le critère n’est atteint dans aucun de ces deux scénarios sur la grille étudiée. Cela ne démontre pas qu’il serait impossible à tout budget supérieur ; nous n’avons pas simulé ces budgets.
Sensibilité aux hypothèses de mesure
Correction par référence, mêmes campagnes appariées.
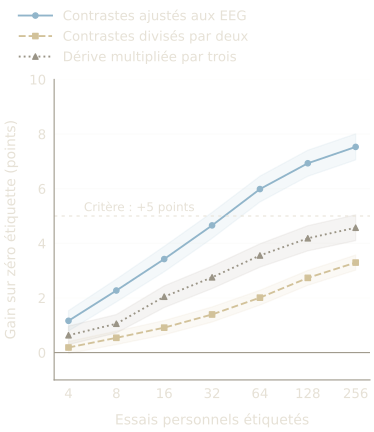
La référence contaminée donne 57,2 % à 64 essais, contre 58,1 % avec la référence indépendante du signal utile. Le débruitage peut enlever de l’information recherchée. Une trace plus lisse ou une erreur de reconstruction plus faible ne dispense donc pas de vérifier la tâche finale.
Les contrastes empiriques ont été estimés sur peu d’essais et peuvent être surestimés. Le scénario à contraste réduit montre la conséquence possible de cette incertitude ; il n’en fournit pas une correction exacte. La dérive observée vient de trois runs d’une même séance, sans mesure de changement entre jours, de fatigue ni d’apprentissage humain.
6. Ce que nous retenons des laboratoires chinois
Beihang et son institut de Ningbo interviennent sur le champ avant la mesure MEG. Dou et al., 2025, associent enceinte blindée, bobines à faible bruit et commande active de compensation. Le capteur mesure le champ résiduel et la commande le corrige. Notre atténuation hypothétique ne reproduit ni ce montage ni ses performances.
À Shenzhen, le NCCLab de SUSTech construit des comparaisons contrôlées. Dans EEGdenoiseNet, les auteurs contaminent des EEG de référence avec des artefacts oculaires ou musculaires et évaluent la reconstruction. Nous retenons ce principe de perturbation connue. Notre expérience utilise son propre modèle statistique, sans reprendre leurs réseaux ni leurs résultats.
Trois problèmes restent distincts : le parasite extérieur mesuré par les capteurs, les artefacts du corps et le changement des caractéristiques entre personnes ou entre séances. Pour l’EEG, la séparation de composantes et le filtrage fréquentiel sont d’autres outils. Leur effet sur l’information utile doit être contrôlé. Un résultat de compensation magnétique ne donne pas directement un nombre d’essais de calibration EEG.
7. Ce que les contrôles établissent
Les 48 000 décisions d’une campagne vérifiée coïncident avec un calcul indépendant de densités gaussiennes dans SciPy. La correction par référence est vérifiée contre scikit-learn, et les vingt seuils sont recalculés séparément. Un exemple analytique confirme le générateur. Dans le scénario sans différence entre classes, le plus grand écart du score moyen à 50 % est de 0,13 point.
Nous avons également ajusté un modèle sur deux runs humains et examiné le troisième : 93,1 % des observations sont dans une ellipse gaussienne indicative à 95 %. Ce diagnostic vérifie un aspect de la dispersion. Les paramètres de l’ellipse étant estimés, ce n’est ni un test exact ni une validation du nombre futur d’essais nécessaires.
Les résultats utiles de cette expérience sont les courbes conditionnelles, leurs coûts de calibration et leur sensibilité. Une étude humaine future devra confronter ces prévisions à de nouvelles séances, mesurer le bruit réel, réserver les essais chronologiquement et compter aussi les commandes involontaires au repos. Le Monte-Carlo nous aide à définir cette étude et à identifier les hypothèses dont son succès dépend.