BCI : un décodeur face à une nouvelle personne
Explication
Nous avons traité 540 essais EEG de 12 personnes pour poser une question précise : un décodeur entraîné sur certains cerveaux fonctionne-t-il sur une personne qu’il n’a jamais vue ? Les enregistrements viennent de données ouvertes existantes. Les participants devaient imaginer un mouvement de la main gauche ou de la main droite, selon une consigne visuelle.
Notre modèle simple atteint 55,3 % lorsqu’il apprend sur d’autres enregistrements de la même personne, et 51,8 % lorsque la personne testée est entièrement absente de l’apprentissage. La mesure donne le même poids aux deux classes ; une réponse constamment « gauche » vaut 50 %. Le premier résultat indique une association faible dans ce cadre exploratoire. Le second ne suffit pas à établir un décodage au-delà de notre contrôle par mélange des étiquettes.
Ce résultat concerne une méthode élémentaire et un petit sous-ensemble. Il ne fixe aucune limite aux BCI. Il montre pourquoi « le logiciel reconnaît une tâche » et « le logiciel fonctionne pour un nouvel utilisateur » doivent être vérifiés séparément. Nous publions aussi les scores individuels, pour que la moyenne ne cache pas les écarts.
Les interfaces implantées récentes atteignent d’autres capacités, notamment pour communiquer. Nous examinons ci-dessous quatre études de 2026, puis notre propre analyse. Les tâches, les capteurs et les populations diffèrent : leurs pourcentages ne se comparent pas directement à ceux de notre EEG.
Analyse détaillée
1. Quatre résultats récents, quatre difficultés concrètes
Utiliser une BCI chez soi. Card et al., juin 2026, documentent plus de 3 800 heures chez une personne implantée, avec 56 mots par minute en moyenne en usage personnel. Les 99,2 % d’exactitude par mot concernent une tâche de copie ; en usage personnel, 53,3 % des phrases sont jugées immédiatement entièrement correctes. Les unités diffèrent. L’installation reste assistée et le système se recalibre en arrière-plan.
Parler et faire un geste simultanément. Brosler et al., septembre 2026, étudient des mouvements isolés chez 3 personnes, et des données simultanées chez 2. La copie simultanée quantifiée en temps réel concerne une personne. L’apprentissage de plusieurs contextes aide à limiter les activations indésirables d’une modalité quand seule l’autre est voulue. Les démonstrations de conversation restent limitées ; elles ne valident pas une interaction libre générale.
Mesurer un bénéfice perceptif. Choudhari et al., mai 2026, décodent l’attention auditive pour renforcer une voix parmi des voix concurrentes. Ils évaluent ensuite compréhension et préférence. Les 4 participants sont enregistrés par électrodes intracrâniennes pendant un bilan d’épilepsie et déclarent une audition normale. Ce résultat ne valide donc pas un appareil EEG grand public destiné à la perte auditive.
Transférer entre personnes. Spalding et al., juillet 2026, alignent des signaux de parole effectivement produite chez 8 personnes. L’alignement utilise des données d’apprentissage du patient cible, en gardant ses données de test à part. « Entre personnes » ne signifie donc pas « sans calibration ». Le transfert à une personne paralysée demeure une question distincte.
Ces études orientent notre question de recherche : mesurer ce qui reste valable quand les conditions changent. Il faut examiner les données nécessaires au démarrage, les adaptations pendant l’usage, les activations non voulues et le bénéfice fonctionnel. Un score obtenu dans une tâche guidée ne répond pas à toutes ces questions.
2. Les signaux que nous avons effectivement analysés
Nous avons téléchargé 36 fichiers EDF du jeu EEG Motor Movement/Imagery de PhysioNet, attribué à Gerwin Schalk et aux contributeurs BCI2000, sous licence Open Data Commons Attribution 1.0. Le sous-ensemble comprend les identifiants S001 à S012 et les enregistrements 04, 08 et 12. Ces derniers correspondent à l’imagerie main gauche/main droite, comme le précise aussi la documentation MNE.
Les annotations donnent 274 essais « gauche » et 266 essais « droite ». Aucun essai de ces deux classes n’a été écarté selon son amplitude ou son résultat. Les périodes de repos sont hors de la tâche choisie. Le sous-ensemble et les paramètres ont été écrits avant le premier calcul des scores, sans préenregistrement externe ni sélection selon les performances.
Les URL, tailles et empreintes SHA-256 des fichiers bruts sont conservées. Les caractéristiques dérivées, les étiquettes, les prédictions et le protocole sont versionnés. Il s’agit d’une réanalyse de mesures existantes, sans nouvelle collecte humaine Aeternam.
3. Un modèle volontairement simple, deux séparations des données
Chaque essai fournit une fenêtre de trois secondes, de 0,5 à 3,5 secondes après la consigne. Nous utilisons trois électrodes, C3, Cz et C4, et deux bandes de fréquences : de 8 à moins de 13 Hz, puis de 13 à moins de 30 Hz. Cela donne 6 caractéristiques, les logarithmes des puissances par canal et par bande. Le calcul retire la moyenne du segment, applique une fenêtre de Hann et intègre le périodogramme unilatéral. La référence enregistrée est conservée.
Le classifieur est une analyse discriminante linéaire, avec probabilités a priori égales et une régularisation fixée à 0,1 vers une identité de même trace. La standardisation et le modèle sont ajustés uniquement sur l’apprentissage. Aucun paramètre n’est optimisé sur les résultats présentés.
- Personne entièrement réservée, évaluation principale. Apprendre sur onze personnes et prédire les essais de la douzième, puis répéter pour chacune. Aucun signal de la personne testée ne sert à ajuster son décodeur.
- Enregistrement réservé, évaluation secondaire. Pour chaque personne, apprendre sur deux de ses enregistrements et prédire le troisième, puis permuter leurs rôles. Ici, le modèle connaît déjà des données de cette personne.
Un enregistrement, ou run, est un bloc de tâches du jeu. Le réserver ne revient pas à tester une autre journée. Les deux runs d’apprentissage peuvent le précéder ou le suivre : ce n’est pas une validation prospective après calibration. Les deux évaluations changent aussi la quantité et la provenance de l’apprentissage. Leur différence n’est pas une estimation causale de l’effet de la calibration.
Il y a 12 séparations apprentissage/test pour la première évaluation, 36 pour la seconde. Chaque essai est prédit une seule fois hors apprentissage dans chacune. Nous calculons l’exactitude équilibrée sur les prédictions de chaque personne, puis la moyenne des personnes. Aucune fenêtre d’un même essai ne se retrouve des deux côtés.
4. Résultats et contrôles
| Données réservées au test | Exactitude équilibrée moyenne | p de permutation, corrigé par Holm |
|---|---|---|
| Personne entière | 51,8 % | 0,149 |
| Run, même personne | 55,3 % | 0,020 |
L’exactitude équilibrée est la moyenne du taux de bonnes réponses sur chaque classe. Sa référence constante vaut 50 %, même si les effectifs gauche/droite diffèrent. Entre personnes, les scores observés vont de 40,8 à 68,3 %. Pour les runs réservés, ils vont de 40,8 à 75,6 %. Ces étendues décrivent notre échantillon, pas l’incertitude dans la population.
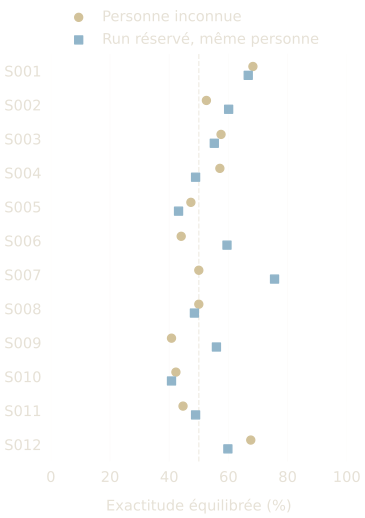
Lire les scores de chaque personne
| Personne | Personne entière réservée | Run réservé, même personne |
|---|---|---|
| S001 | 68,3 % | 66,7 % |
| S002 | 52,6 % | 60,1 % |
| S003 | 57,5 % | 55,2 % |
| S004 | 57,1 % | 48,9 % |
| S005 | 47,3 % | 43,2 % |
| S006 | 44,0 % | 59,5 % |
| S007 | 50,0 % | 75,6 % |
| S008 | 50,0 % | 48,5 % |
| S009 | 40,8 % | 56,0 % |
| S010 | 42,3 % | 40,8 % |
| S011 | 44,7 % | 48,9 % |
| S012 | 67,6 % | 59,8 % |
Le contrôle mélange les étiquettes gauche/droite à l’intérieur de chaque bloc personne/run, puis réentraîne entièrement les deux évaluations. Nous avons exécuté 200 permutations, avec une graine fixée. Le test est unilatéral : compter les scores mélangés au moins aussi élevés que le score observé, en ajoutant un au numérateur et au dénominateur. Holm corrige les deux tests.
Le résultat sur une personne inconnue ne permet pas de conclure à un décodage établi au-delà de ce contrôle. Cela ne prouve pas l’absence d’information. Le résultat sur un run réservé indique une association faible, sous les hypothèses du test. Une p-valeur n’est ni la probabilité que le modèle soit vrai, ni celle qu’une prédiction particulière soit juste. Le nombre limité de permutations rend leur estimation grossière.
Nous avons contrôlé le calcul spectral d’un essai contre SciPy, puis les prédictions des deux évaluations contre une implémentation indépendante de l’analyse discriminante dans scikit-learn, avec les mêmes choix de standardisation, de covariance et d’a priori. Aucune prédiction ne diffère. Ce contrôle vérifie les calculs ; il ne suffit pas à valider l’interprétation biologique.
5. Ce que cette analyse laisse ouvert
La consigne n’est pas une mesure pure de l’intention. Les classes sont associées à une présentation visuelle. Des réponses sensorielles, des mouvements résiduels ou d’autres artefacts peuvent contribuer au signal. Les canaux centraux et la fenêtre après consigne ne suffisent pas à les exclure. Une classification réussie ne démontrerait donc pas, à elle seule, la lecture d’une intention motrice isolée.
Les permutations supposent que les essais sont échangeables à l’intérieur de chaque bloc. Une dépendance temporelle pourrait fragiliser cette hypothèse. Les modèles des différents plis partagent aussi des données d’apprentissage : nous ne traitons pas ces plis comme des expériences indépendantes et ne fabriquons pas un intervalle binomial sur l’ensemble des prédictions.
Le jeu est petit, choisi par commodité, et le modèle utilise seulement trois canaux et six puissances. Il n’évalue ni une architecture performante réglée avec soin, ni tous les participants disponibles. Cette analyse ne reproduit pas un résultat publié de MOABB et ne revendique pas une nouvelle méthode de décodage.
Enfin, nous exploitons une fenêtre complète de trois secondes dans une tâche guidée. Nous n’avons mesuré ni commande en temps réel, ni débit en usage libre, ni fausses commandes pendant le repos. Ces données ne répondent pas non plus aux questions d’intervention sur la vision ou d’intervention sur la mémoire.
6. La prochaine contribution utile
Le prochain travail proposé est une comparaison sur une nouvelle tranche de données réservée à l’avance. Notre modèle simple servirait de témoin face à des méthodes qui exploitent mieux la distribution spatiale du signal, par exemple des filtres spatiaux ou des modèles de covariance. Le réglage resterait entièrement dans les données d’apprentissage, puis la comparaison serait exécutée une fois sur le lot réservé. Cette expérience n’a pas encore été réalisée.
Une seconde question porterait sur l’adaptation : combien d’essais d’une nouvelle personne faut-il pour améliorer son score ? Il faudrait séparer chronologiquement calibration et évaluation, à quantité d’apprentissage comparable. Une véritable étude entre journées demanderait un jeu qui documente ces journées. Pour aller vers un usage libre, il faudrait aussi inclure le repos et compter les commandes déclenchées sans intention.
Le travail accompli ici fournit un point de départ vérifiable : des signaux réellement traités, des séparations explicites et un résultat modeste conservé tel quel. Les prochaines comparaisons devront conserver cette séparation entre le choix de la méthode et son évaluation.